B木とは?DBインデックスに使われる理由を図解で解説
以前の記事「ハッシュ法とは?チェイン法とオープンアドレス法の違いを図解で解説」では、キーから添字を直接計算することでO(1)に近い探索を実現するハッシュ法を紹介しました。しかしハッシュ法には「範囲検索が苦手」という弱点があります。この弱点を克服し、DBインデックスの実装で広く使われているデータ構造が「B木(B-tree)」です。今回はB木の仕組みと、なぜDBインデックスに採用されているのかを整理します。
なぜハッシュ法だけでは足りないのか
前回のハッシュ法の記事で見た通り、ハッシュ法はキーの完全一致検索であればO(1)に近い性能を発揮します。しかし、次のような検索は苦手です。
- 「100〜200の範囲に含まれるデータを取得する」といった範囲検索
- 「キーの昇順に並べて取得する」といったソート済みの走査
ハッシュ関数はキーの値をバラバラの添字に変換してしまうため、隣り合う添字に類似したキーが並ぶ保証がありません。範囲検索やソートを高速に行うには、キーの大小関係を保ったまま格納する木構造のデータ構造が必要になります。これが二分探索木、そしてその発展形であるB木です。
二分探索木の限界
二分探索木(Binary Search Tree)は、各ノードが最大2つの子を持ち、「左の子は自分より小さい値、右の子は自分より大きい値」という規則でデータを格納する木構造です。理想的にバランスが取れていれば、探索は木の高さに比例するO(log n)で行えます。
class BSTNode {
  constructor(
    public key: number,
    public left: BSTNode | null = null,
    public right: BSTNode | null = null
  ) {}
}
ただし二分探索木には実務上の弱点があります。
- 偏りによる性能劣化: キーを昇順のまま挿入し続けると、木が一直線に伸びてしまい(連結リストと同じ状態)、探索がO(n)まで悪化する
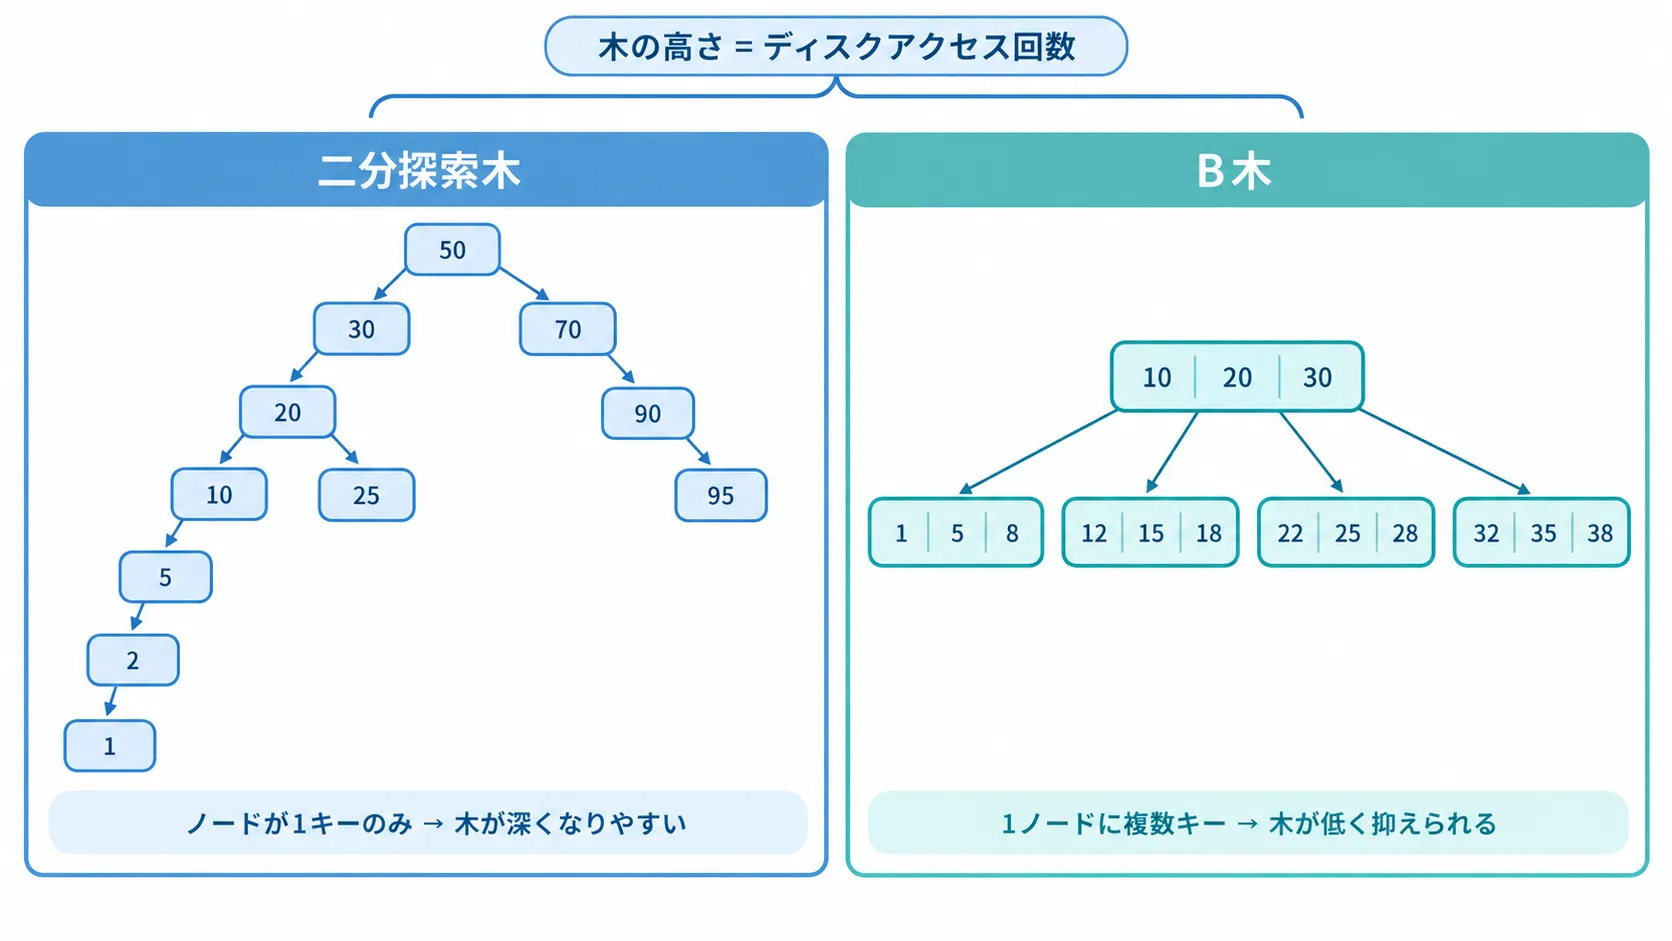
- ディスクI/Oとの相性の悪さ: 1ノードにつき1つのキーしか持たないため、大量データを扱う場合、木の高さ(=ディスクアクセス回数)が深くなりやすい
DBのように「メモリではなくディスク(またはSSD)上のデータ」を扱う場合、1回のディスクアクセスにはメモリアクセスの数千倍以上の時間がかかります。木の高さがそのままディスクアクセス回数に直結するため、「いかに木を低く保つか」がDBインデックスの構造にとって死活問題になります。
B木の仕組み:1ノードに複数のキーを持たせる
B木は、二分探索木の「1ノード1キー、子は最大2つ」という制約を緩め、1ノードに複数のキーを持たせ、子の数も増やすことで、木の高さを大幅に抑えたデータ構造です。
次数(次数 m のB木は「m分木」とも呼ばれる)を持つB木の主な性質は次の通りです。
- 1つのノードは最大
m-1個のキーを持つ - 1つのノードは最大
m個の子ノードを持つ - ノード内のキーは昇順に並んでおり、キー同士の間にある子ノードには、その範囲に収まる値だけが格納される
- すべての葉ノードが同じ深さになる(バランスが常に保たれる)
例: 次数4のB木のノード(キーを3つ持ち、子を4つ持てる)

        [ 10 | 20 | 30 ]
       /     |     |     \
   (<10)  (10-20) (20-30) (>30)
1ノードに複数のキーを持たせることで、同じ深さでもより多くのデータを格納でき、結果として木の高さを低く抑えられます。例えば次数100のB木であれば、100万件のデータでも木の高さはわずか3程度に収まります。木の高さが低いということは、そのままディスクアクセス回数が少なくて済むということであり、これがB木がDBインデックスに採用される最大の理由です。
挿入とノード分割
B木への挿入は、該当する葉ノードにキーを追加するだけで済む場合がほとんどですが、ノードのキー数が上限(m-1個)を超えるとノード分割が発生します。
- ノードの中央のキーを親ノードへ押し上げる
- 残りのキーを、中央より小さいグループと大きいグループの2つのノードに分割する
- 親ノードでも同様にキー数が上限を超えれば、再帰的に分割が親へ伝播する
この分割によって、B木は挿入を繰り返しても常にすべての葉が同じ深さを保ち続けます。二分探索木のように「挿入順序によって木が偏る」という問題が起きない設計になっています。
B+木:DBで実際に使われる発展形
多くのDBMS(MySQLのInnoDBやPostgreSQLなど)が実際に採用しているのは、B木そのものではなく**B+木(B+tree)**という発展形です。B木とB+木の違いは次の点です。
| 観点 | B木 | B+木 |
|---|---|---|
| データの格納場所 | 全ノード(内部ノードも葉ノードも)にデータを持つ | 葉ノードにのみデータを持つ。内部ノードはキーだけを持つ |
| 葉ノード同士の連結 | なし | 葉ノード同士が連結リストで横に繋がっている |
| 範囲検索 | 木を辿りながら検索 | 該当する葉に到達後、連結リストを辿るだけで高速に範囲検索できる |
B+木は内部ノードにデータを持たない分、1ノードあたりにより多くのキーを詰め込めるため、B木よりもさらに木の高さを低く抑えられます。加えて、葉ノード同士が連結リストで繋がっているため、「キーaからキーbまでの範囲を取得する」といった範囲検索やソート済み走査を、葉から葉へ横移動するだけで効率的に処理できます。
ハッシュ法とB木(B+木)の比較
| 観点 | ハッシュ法 | B木・B+木 |
|---|---|---|
| 完全一致検索 | O(1)に近く非常に高速 | O(log n) |
| 範囲検索・ソート済み走査 | 苦手(キーの大小関係を保持していないため) | 得意(キーの大小関係を保ったまま格納) |
| データの偏りへの耐性 | 負荷率が高いと性能劣化(チェイン法・オープンアドレス法参照) | 分割によって常にバランスを維持 |
| DBでの典型的な用途 | 等価検索用のハッシュインデックス | 主キー・複合キーなど大半のインデックス |
多くのDBが「等価検索が中心ならハッシュインデックス」「範囲検索やソートも必要ならB+木インデックス」と使い分けられるようになっているのは、まさにこの特性の違いに基づいています。PostgreSQLのデフォルトインデックスがB-treeであるのも、等価検索と範囲検索の両方を単一の構造でバランスよくこなせるためです。
実務での活かし方
B木・B+木の理解は、実務でのインデックス設計に直結します。
WHERE句がインデックスを使えるか:WHERE age > 30のような範囲検索は、B+木インデックスであれば効率的に処理できますが、ハッシュインデックスでは使えません。実行計画(EXPLAIN)を確認する際、この特性を理解しているとインデックスの選定理由が説明しやすくなります- 複合インデックスの列順: B+木の複合インデックスは、先頭の列から順に木構造で並んでいるため、
WHERE句の条件が先頭列から連続していないとインデックスが効きにくいという特性があります。「なぜこの列順にすべきか」を若手に説明する際、B木の構造から理由を語れると説得力が増します - Snowflakeなどのデータ基盤との対比: Snowflakeのマイクロパーティションのようなカラムナ型ストレージは、B木インデックスとは異なるアプローチ(min/maxのメタデータによるプルーニング)でスキャン範囲を絞り込みます。トランザクション系DBのB+木インデックスと、分析基盤のプルーニングという、目的に応じた異なる最適化手法を対比して理解しておくと、アーキテクチャ選定の引き出しが増えます
自分も以前、複合インデックスの列順を意識せずに設計したテーブルで、想定していたクエリがインデックスを使わずフルスキャンになってしまった経験があります。B+木が「先頭列から順に絞り込む木構造である」という前提を理解してからは、WHERE句の条件とインデックスの列順を対応づけて設計する習慣がつきました。
試験対策のポイント
応用情報技術者試験でB木が問われる際は、以下の観点が狙われやすいです。
- 二分探索木とB木の違い(1ノードに持てるキー数・子の数)
- ノード分割が発生する条件と、分割によって木のバランスが保たれる仕組み
- B木の高さがディスクアクセス回数に直結するという実務的な意味
- B木とB+木の違い(データの格納場所、葉ノード同士の連結)
- ハッシュ法との使い分け(完全一致検索 vs 範囲検索)
擬似言語の問題では、キーを順に挿入していった際にノード分割がどのタイミングで起きるかをトレースさせる出題が定番です。「上限を超えたら中央のキーを親へ押し上げる」という分割ルールを、実際に手を動かして図に描きながら覚えておくと得点しやすくなります。
まとめ
B木は、1ノードに複数のキーを持たせることで木の高さを低く抑え、二分探索木が抱える「偏りによる性能劣化」と「ディスクアクセス回数の増大」という課題を解決したデータ構造です。実際のDBMSではさらに発展したB+木が使われており、葉ノード同士の連結によって範囲検索やソート済み走査を効率的に処理できます。ハッシュ法が完全一致検索に強い一方、B木・B+木は範囲検索やソートに強いというトレードオフを理解しておくと、試験対策だけでなく実務でのインデックス設計やクエリチューニングの判断材料としても役立ちます。