O記法とは?計算量の考え方をアルゴリズムの具体例で解説
応用情報技術者試験の基礎理論分野やアルゴリズム分野では、O記法(オーダー記法)を使った計算量の比較が定番で出題されます。実務でも「このコードは遅い」を感覚だけでなく計算量という言葉で説明できると、若手への指導やコードレビューの説得力が大きく変わります。今回はO記法の考え方を、代表的なアルゴリズムの具体例とともに整理します。
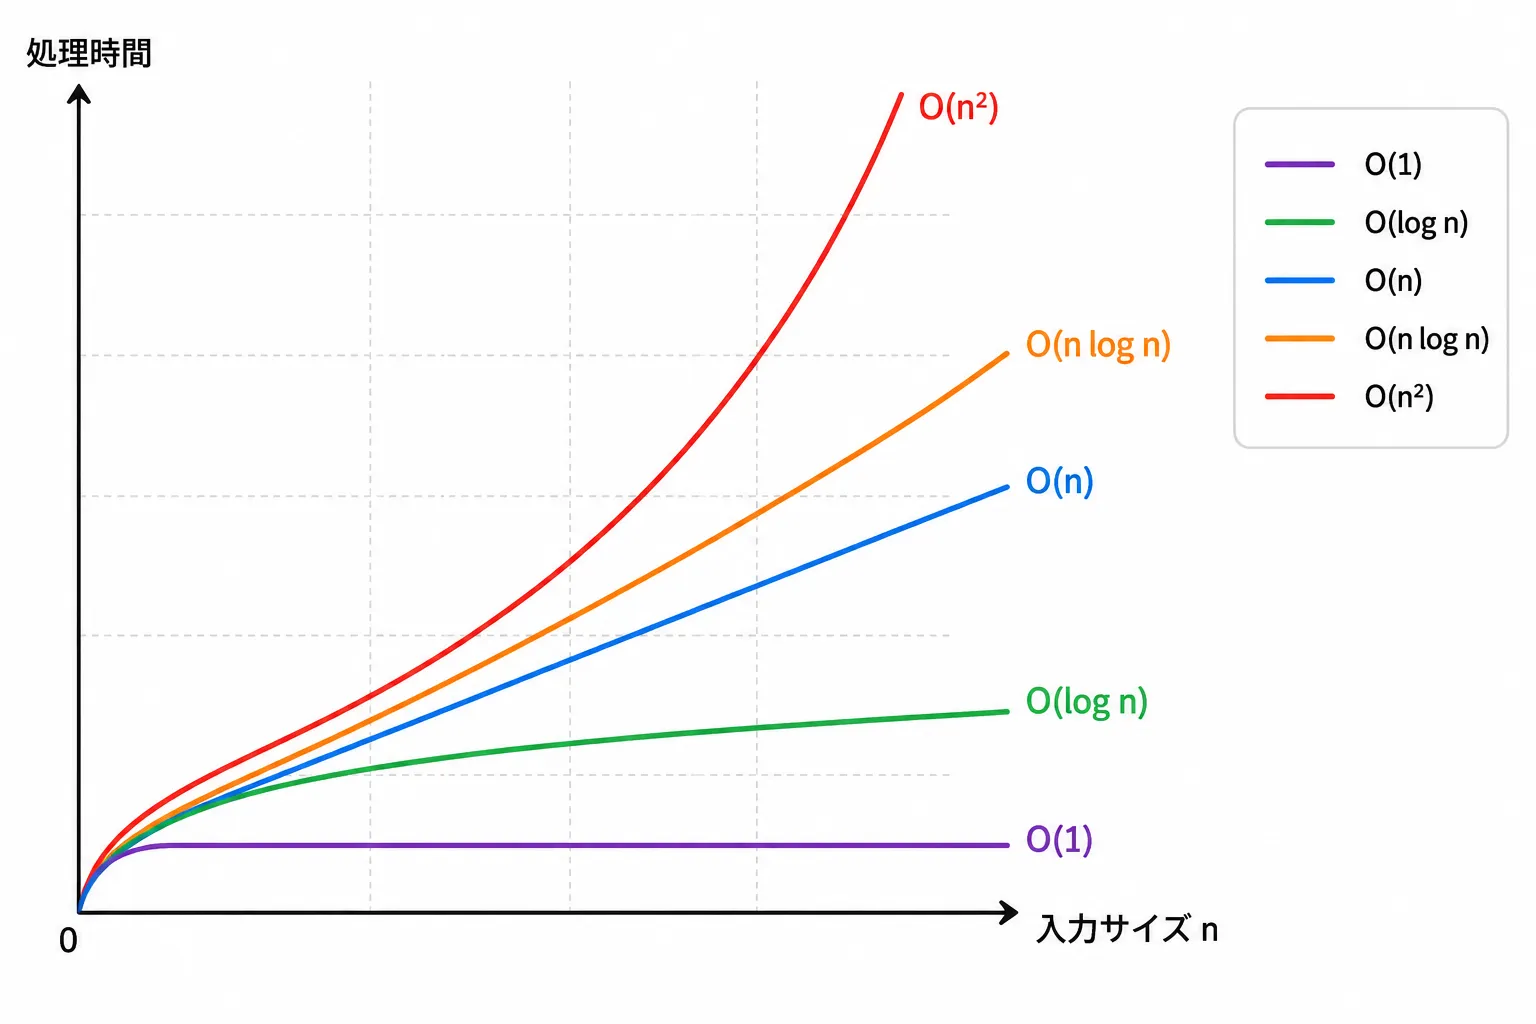
O記法とは何か
O記法は、アルゴリズムの処理時間(または使用メモリ量)が、入力データ数 n の増加に対してどのくらいの割合で増えていくかを表す記法です。「計算量」や「オーダー」とも呼ばれます。
O(処理時間の増加の仕方)例えば O(n) は「入力サイズが2倍になれば、処理時間もおよそ2倍になる」ことを意味します。O(n^2) であれば「入力サイズが2倍になれば、処理時間はおよそ4倍になる」ことを意味します。
O記法で重要なのは、具体的な秒数ではなく「増加の傾向」を表しているという点です。定数倍の違い(1回の処理が1msか2msか)や、影響の小さい項は無視し、入力サイズが大きくなったときに支配的になる項だけに注目します。
代表的な計算量とアルゴリズムの具体例
計算量が小さい順に、代表的なオーダーと具体例を見ていきましょう。
O(1):定数時間
入力サイズ n に関係なく、常に一定の処理時間で終わる計算量です。
function getFirstElement(arr: number[]): number {
  return arr[0]; // 配列の要素数に関わらず一定時間
}
配列のインデックスアクセスや、ハッシュテーブル(連想配列)へのキーアクセスがO(1)の代表例です。
O(log n):対数時間
入力サイズが増えても、処理時間の増加が非常に緩やかな計算量です。
function binarySearch(arr: number[], target: number): number {
  let left = 0;
  let right = arr.length - 1;
  while (left <= right) {
    const mid = Math.floor((left + right) / 2);
    if (arr[mid] === target) return mid;
    if (arr[mid] < target) left = mid + 1;
    else right = mid - 1;
  }
  return -1;
}
二分探索が代表例です。1回の比較ごとに探索範囲が半分になるため、データ数が2倍になっても比較回数は1回しか増えません。データ数が100万件でも、比較回数は最大20回程度に収まります。
O(n):線形時間
入力サイズに比例して処理時間が増える計算量です。
function findMax(arr: number[]): number {
  let max = arr[0];
  for (const value of arr) {
    if (value > max) max = value;
  }
  return max;
}
配列を1回だけ走査する線形探索や最大値検索がO(n)の代表例です。
O(n log n):線形対数時間
多くの効率的なソートアルゴリズムがこの計算量に分類されます。
function mergeSort(arr: number[]): number[] {
  if (arr.length <= 1) return arr;
  const mid = Math.floor(arr.length / 2);
  const left = mergeSort(arr.slice(0, mid));
  const right = mergeSort(arr.slice(mid));

  // 2つのソート済み配列を先頭から比較しながら1つにまとめる
  const result: number[] = [];
  let i = 0;
  let j = 0;
  while (i < left.length && j < right.length) {
    result.push(left[i] <= right[j] ? left[i++] : right[j++]);
  }
  return [...result, ...left.slice(i), ...right.slice(j)];
}
マージソートやクイックソート(平均計算量)が代表例です。「データを半分に分ける処理(log n)」を「全体に対して行う(n)」ため、n × log n という計算量になります。
O(n^2):2乗時間
入力サイズの2乗に比例して処理時間が増える計算量です。
function hasDuplicates(arr: number[]): boolean {
  for (let i = 0; i < arr.length; i++) {
    for (let j = i + 1; j < arr.length; j++) {
      if (arr[i] === arr[j]) return true;
    }
  }
  return false;
}
二重ループで全要素同士を比較するバブルソートや、素朴な重複チェックがO(n^2)の代表例です。データ数が10倍になると、処理時間は約100倍になるため、大規模データでは特に注意が必要です。
計算量の比較表
| 記法 | 呼び方 | 具体例 | n=1,000での目安 |
|---|---|---|---|
| O(1) | 定数時間 | 配列のインデックスアクセス | 1 |
| O(log n) | 対数時間 | 二分探索 | 約10 |
| O(n) | 線形時間 | 線形探索、配列の走査 | 1,000 |
| O(n log n) | 線形対数時間 | マージソート、クイックソート | 約10,000 |
| O(n^2) | 2乗時間 | バブルソート、二重ループの全探索 | 1,000,000 |
n=1,000程度であればO(n)とO(n^2)の差はまだ体感しにくいこともありますが、n=100,000を超えるとO(n^2)のアルゴリズムは実用に耐えなくなることがほとんどです。
O記法を求めるときの考え方
O記法を導出する際のポイントは、次の2つです。
- 最も影響の大きい項だけを残す: 例えば処理時間が
3n^2 + 5n + 10と表せる場合、nが大きくなるにつれてn^2の項が支配的になるため、O記法ではO(n^2)と表記します - 定数倍は無視する:
3n^2も100n^2も、増加の傾向としては同じ「2乗」なので、どちらもO(n^2)です
この「支配的な項だけを残し、定数を無視する」という考え方は、応用情報技術者試験の計算問題でも頻出のポイントです。ループがネストしている場合は掛け算、ループが連続している場合は足し算(結果的に大きい方が残る)と覚えておくと、コードから計算量を素早く見積もれるようになります。
実務での注意点
O記法は試験だけの話ではなく、実務のコードレビューやアルゴリズム選定でも直接役立ちます。
- 二重ループには注意を払う: 配列や取得したAPIレスポンスに対して
forの中でfindやincludesを使うと、意図せずO(n^2)になっていることがあります。ループ内での配列検索は、事前にMapやSetに変換しておくことでO(n)まで改善できます - ライブラリの内部実装も意識する: 配列の
indexOfやincludesはO(n)であるのに対し、Set.has()やMap.get()はO(1)です。大量データを繰り返し検索する処理では、データ構造の選択が性能に直結します - 計算量が同じでも定数倍の差は残る: O記法は「傾向」を表すものであり、同じO(n)同士でも実際の実行速度には差が出ます。ボトルネックの特定には、計算量の見積もりに加えてプロファイリングも併用するのが実務的です
自分も過去に、若手が書いたコードで「配列の中から一致する要素を探す」処理がループの中に入っており、データ量が増えるにつれてバッチ処理が線形以上に遅くなっていく不具合に遭遇したことがあります。その際、Map を使ってO(n^2)からO(n)に改善したことで、処理時間が大幅に短縮された経験があります。計算量を意識したコードレビューは、パフォーマンス問題の早期発見に直結します。
試験対策のポイント
応用情報技術者試験でO記法・計算量が問われる際は、以下の観点が狙われやすいです。
- 代表的なアルゴリズム(線形探索、二分探索、各種ソート)の計算量を正しく対応づけられるか
- コード(擬似言語)を読んで、ループの構造から計算量を導出できるか
- 複数のオーダーを計算量の小さい順・大きい順に並び替えられるか
- 「最も影響の大きい項だけを残し、定数倍は無視する」というO記法の考え方を理解しているか
擬似言語の問題では、ループがネスト構造になっているか、逐次構造になっているかを図解しながら読み解く癖をつけておくと、初見のコードでも計算量を素早く見積もれます。
まとめ
O記法は、アルゴリズムの処理時間が入力サイズ n に対してどのくらいの割合で増えるかを表す記法で、O(1)・O(log n)・O(n)・O(n log n)・O(n^2)といった代表的なオーダーを覚えておくことが試験対策・実務どちらにも役立ちます。特に実務では、ループ内での配列検索がO(n^2)を生みやすいポイントであり、データ構造を見直すだけで性能が大きく改善するケースが多いので、コードレビューの観点として意識しておくとよいでしょう。