ハッシュ法とは?チェイン法とオープンアドレス法の違いを図解で解説
応用情報技術者試験の基礎理論分野では、O(1)に近い高速な探索を実現する手法として「ハッシュ法」が定番で出題されます。以前の記事「O記法とは?計算量の考え方をアルゴリズムの具体例で解説」でも触れた通り、配列のインデックスアクセスはO(1)ですが、ハッシュ法はキーからそのインデックスを計算することで、探索そのものをO(1)に近づける仕組みです。今回はハッシュ法の基本と、避けて通れない「衝突(コリジョン)」への対策を整理します。
ハッシュ法とは何か
ハッシュ法は、キー(探索対象のデータ)をハッシュ関数に通してハッシュ値を求め、そのハッシュ値をハッシュテーブル(配列)の添字として使うことで、データの格納・探索を高速に行う手法です。
添字 = ハッシュ値 = ハッシュ関数(キー) % テーブルサイズ線形探索がO(n)、二分探索がO(log n)であるのに対し、ハッシュ法は理想的な条件下ではO(1)で目的のデータにたどり着けます。「キーから直接位置を計算する」という発想が、順に比較していく他の探索アルゴリズムとの決定的な違いです。
function simpleHash(key: string, tableSize: number): number {
  let hash = 0;
  for (let i = 0; i < key.length; i++) {
    hash = (hash * 31 + key.charCodeAt(i)) % tableSize;
  }
  return hash;
}
衝突(コリジョン)はなぜ起きるのか
ハッシュ法の最大の課題は**衝突(コリジョン)**です。異なるキーであっても、ハッシュ関数を通した結果として同じ添字が計算されてしまうことがあります。
テーブルサイズが有限である以上、キーの種類がテーブルサイズを超えれば、鳩の巣原理により衝突は理論上避けられません。テーブルサイズに対してデータ数が多くなるほど衝突率が上がるため、この比率(負荷率・充填率、データ数 ÷ テーブルサイズ)をどう管理するかが、ハッシュ法の性能を左右する重要な指標になります。
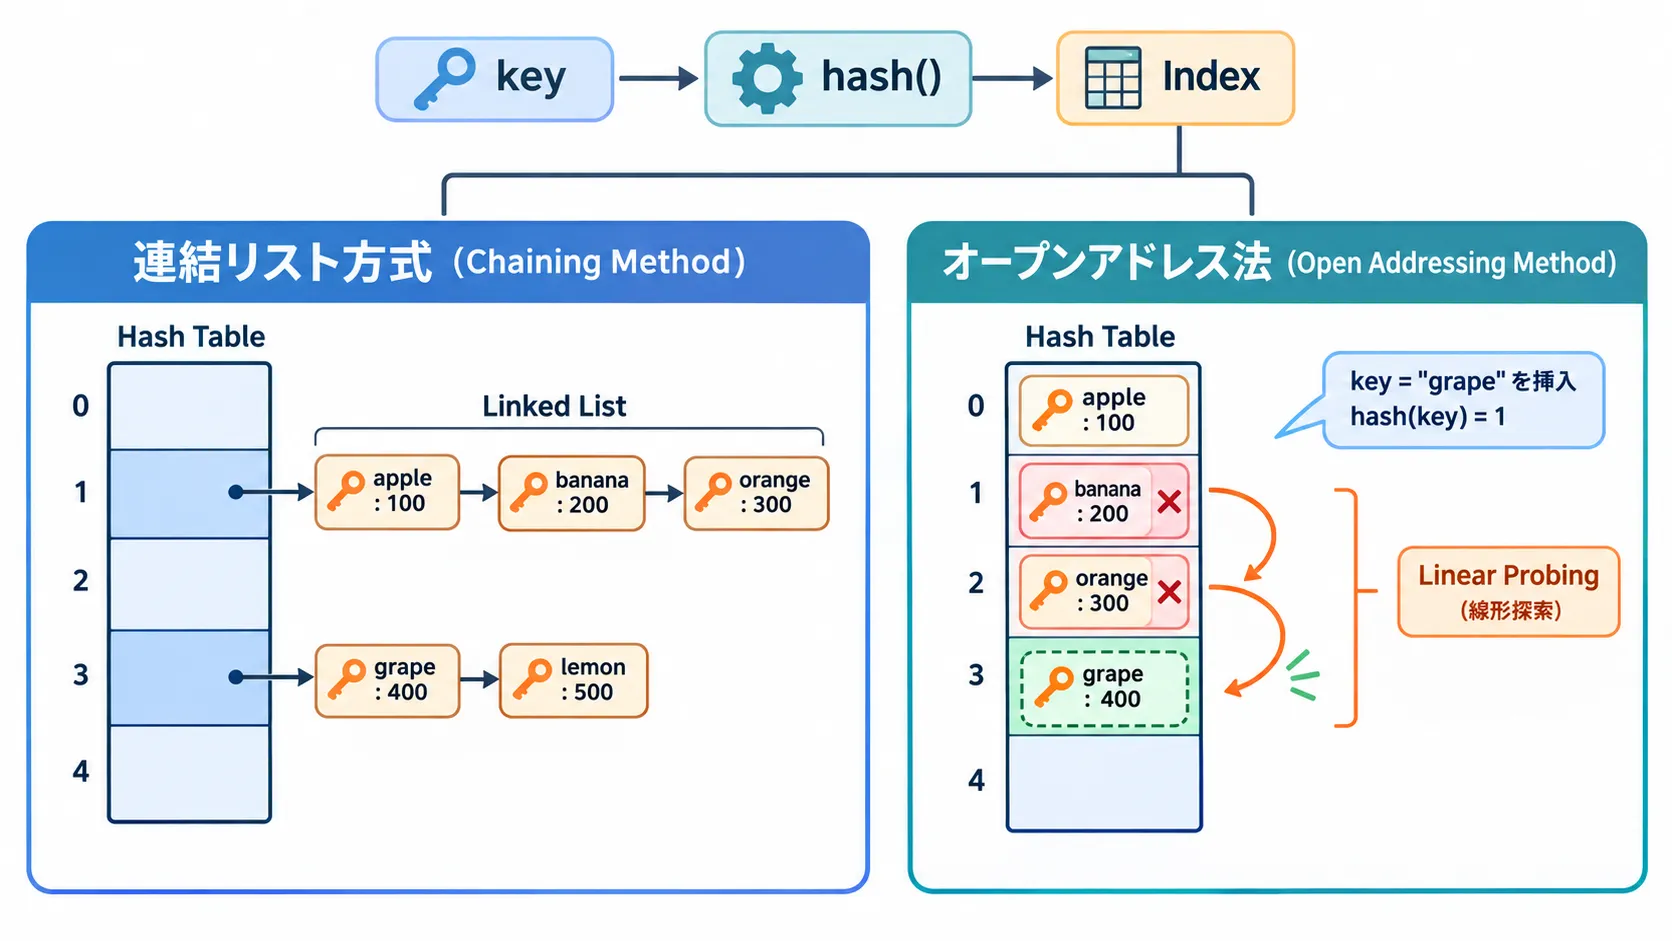
衝突への対策として、代表的な方式が「チェイン法」と「オープンアドレス法」の2つです。
チェイン法:同じ添字に連結リストで対応する
チェイン法(分離連鎖法)は、同じ添字に複数のデータが割り当たった場合、その添字の位置に連結リストをぶら下げて対応する方式です。
- 新しいキーのハッシュ値が既存の添字と衝突した場合、その添字のリストの先頭(または末尾)に追加する
- 探索時は、まず添字にアクセスし、そこにあるリストを先頭から線形に辿って一致するキーを探す
class ChainHashTable<K, V> {
  private buckets: Array<Array<[K, V]>>;

  constructor(size: number) {
    this.buckets = Array.from({ length: size }, () => []);
  }

  private hash(key: K, size: number): number {
    return Math.abs(String(key).length * 31) % size;
  }

  set(key: K, value: V): void {
    const index = this.hash(key, this.buckets.length);
    const bucket = this.buckets[index];
    const existing = bucket.find(([k]) => k === key);
    if (existing) {
      existing[1] = value;
    } else {
      bucket.push([key, value]);
    }
  }

  get(key: K): V | undefined {
    const index = this.hash(key, this.buckets.length);
    return this.buckets[index].find(([k]) => k === key)?.[1];
  }
}- メリット: 実装がシンプルで、負荷率が1を超えても(テーブルサイズよりデータ数が多くても)動作し続ける
- デメリット: 特定の添字にリストが偏って伸びると、その部分の探索がO(n)に近づいてしまう。ポインタ管理のためのメモリオーバーヘッドもある
オープンアドレス法:別の空き番地を探しに行く
オープンアドレス法(開番地法)は、連結リストを使わず、衝突が起きた場合にテーブル内の別の空いている添字を探して格納する方式です。空き番地の探し方にはいくつかのバリエーションがあります。
- 線形探査法: 衝突したら次の添字(+1、+2、+3…)を順に調べ、空いている場所に格納する
- 2次探査法: 衝突したら +1²、+2²、+3²…と間隔を広げながら調べる(同じ位置に偏る「クラスタリング」を緩和する)
- ダブルハッシュ法: 別のハッシュ関数で移動幅を決めて調べる位置を分散させる
class OpenAddressHashTable<V> {
  private keys: (string | undefined)[];
  private values: (V | undefined)[];

  constructor(private size: number) {
    this.keys = new Array(size).fill(undefined);
    this.values = new Array(size).fill(undefined);
  }

  private hash(key: string): number {
    let h = 0;
    for (let i = 0; i < key.length; i++) h += key.charCodeAt(i);
    return h % this.size;
  }

  set(key: string, value: V): void {
    let index = this.hash(key);
    // 線形探査: 空き番地が見つかるまで次の添字を調べる
    while (this.keys[index] !== undefined && this.keys[index] !== key) {
      index = (index + 1) % this.size;
    }
    this.keys[index] = key;
    this.values[index] = value;
  }
}- メリット: 連結リストが不要でデータが配列内に収まるため、メモリ効率がよくキャッシュヒット率も高い
- デメリット: テーブルサイズを超えてデータを格納できない。削除処理が複雑(安易に空欄に戻すと探査の連続性が崩れるため、削除済みを示す特別なマーカーが必要)。負荷率が高くなるとクラスタリングにより性能が急激に劣化する
チェイン法とオープンアドレス法の比較
| 観点 | チェイン法 | オープンアドレス法 |
|---|---|---|
| 衝突時の対応 | 同じ添字に連結リストで追加 | 別の空き添字を探して格納 |
| データ数の上限 | 負荷率1を超えても格納可能 | テーブルサイズが上限 |
| メモリ効率 | リストのポインタ分オーバーヘッドあり | 配列のみで完結し効率的 |
| 削除処理 | リストから該当要素を外すだけで単純 | 探査の連続性を保つため複雑 |
| 負荷率が高い場合の性能劣化 | 緩やか(リストが伸びるだけ) | 急激(クラスタリングが発生) |
試験では「負荷率が上がったときにどちらがより深刻に性能劣化するか」「削除処理が複雑なのはどちらか」という観点の入れ替えがよく狙われます。オープンアドレス法は「配列に収まる代わりに削除が面倒」、チェイン法は「柔軟な代わりにメモリオーバーヘッドがある」というトレードオフの対で覚えておくと整理しやすいです。
実務での活かし方
ハッシュ法は試験だけの知識ではなく、普段使っている Map や Set、オブジェクトのキーアクセスの内部実装そのものです。
- JavaScriptの
Map・Setは内部的にハッシュテーブル:Map.get()やSet.has()がO(1)で高速なのは、内部でハッシュ法が使われているためです。配列のindexOfやincludesがO(n)であるのに対し、大量データの重複チェックやルックアップ処理ではSet・Mapへの置き換えが定石になります - 負荷率を意識した設計: 実務で自前のハッシュテーブル実装に触れる機会は少ないですが、KVS(Redisなど)やDBのハッシュインデックスも同様に負荷率が性能に直結します。データ量に対してテーブルサイズ(バケット数)が小さすぎると、内部的に衝突が増えて性能が劣化するという構造は共通しています
- ハッシュ関数の質が性能を左右する: キーの分布に偏りがあるハッシュ関数を使うと、特定の添字に衝突が集中してしまいます。文字列キーのハッシュ関数として広く使われる「乗算・剰余を組み合わせた分散のよい関数」を選ぶことが、ハッシュ法全体の性能を支える前提になります
自分も以前、大量のユーザーIDに対して配列の includes で重複チェックをしていたバッチ処理が、データ量の増加とともに極端に遅くなった経験があります。Set に置き換えるだけでO(n²)からO(n)に改善できたのですが、これも「Set の中身がハッシュテーブルである」という前提を理解していたからこそ、自信を持って選択できた改善でした。
試験対策のポイント
応用情報技術者試験でハッシュ法が問われる際は、以下の観点が狙われやすいです。
- ハッシュ関数がキーから添字を計算する仕組み(剰余演算を使うことが多い)
- 衝突(コリジョン)が発生する原因と、負荷率(充填率)との関係
- チェイン法とオープンアドレス法、それぞれのメリット・デメリットの対応
- オープンアドレス法における線形探査法・2次探査法・ダブルハッシュ法の違い
- オープンアドレス法での削除処理がなぜ複雑になるか
擬似言語の問題では、ハッシュテーブルへの格納処理をトレースさせ、衝突が起きた際にどちらの方式で処理されるかを問う出題が定番です。「衝突が起きたらどこを見に行くか」を図に描きながら追う癖をつけておくと、初見の問題でも迷わず対応できます。
まとめ
ハッシュ法は、キーからハッシュ関数で添字を直接計算することで、理想的にはO(1)という高速な探索を実現するデータ構造です。ただし衝突は避けられない前提であり、その対策としてチェイン法(連結リストで対応)とオープンアドレス法(別の空き番地を探す)という2つのアプローチがあることを、それぞれのトレードオフとあわせて理解しておくことが試験対策の鍵になります。実務でも Map や Set の高速なルックアップの背後にはこの仕組みがあるため、負荷率やハッシュ関数の質を意識できると、データ構造選定の説得力がぐっと増すはずです。